728x90
반응형

계기

개발 진행 중, 체인 데이터가 깨지는 이슈가 발생하였으나 컨테이너의 health 체크 및 재시동에 이슈가 발생하였음
현재는 본인이 3년전에 세팅한 Docker Swarm 으로 컨테이너 오케스트레이션 중이나, 서비스 고도화로 인한 오케스트레이션해야 할 컨테이너가 다양해지고 많아짐
컨테이너 health 상태 체크 및 정상화에 대한 기능이 필요해짐
서비스 운영시의 서버 문제 발생 및 리소스 문제 대처를 위한 Auto Scaling 기능 역시 필요
이외에 무중단 배포 전략 수행을 위한 옵션 역시 필요함
이를 해결하기 위한 방안에 대하여 고민중, 회사에 제안할 내용의 초안을 작성해본다.


현 상태

  • Docker Swam을 통한 노드 컨테이너 오케스트레이션이 수행되고 있음
    • 오케스트레이션 대상이 블록체인 노드 8개 밖에 없었기에 kubernetes를 사용할 필요가 없어 보였음
  • 그러나 관리 및 오케스트레이션 해야 할 대상이 많고 다양해짐
    • 노드
    • Explorer
    • 어플리케이션들
      • 거래소
      • 지갑
      • 등
    • DB
    • 게이트웨이
    • 모니터링 시스템
      • 자체 제작 Collector 및 대시보드
      • Prometheus
      • Grafana
  • Auto-Scaling, 리소스 할당에 대한 필요성 대두
  • 무중단 배포 전략 도입의 필요성 확인

제안

  • 컨테이너 오케스트레이터(Orchestrator)를 Kubernetes로 변경
    • 더욱 안정적 시스템 운영
    • Auto Scaling

구상

  • 노드 구성
    • Master
    • Worker Nodes
      • Explorer
      • Chain Nodes - 7 nodes
      • DataBase
      • Monitoring
      • Trade Application
      • Wallet Application
  • Pods 단위
    • Explorer pod
    • Blockchain Nodes pod
    • Database pod
    • Services
      • Trade Application
      • Wallet Application
      • etc...
    • Monitoring pod
      • Prometheus
      • Grafana
      • 자체 제작 Collecter, Dashboard
728x90
반응형
728x90
반응형

계기

최근 새로운 솔루션 개발 및 데모를 위한 과정에서 많은 이슈들을 경험하였다.
이를 과정에서 현 개발 환경 및 서버 환경의 분리가 필요함을 느꼈다.
때문에 회사에 새로운 서버 구성을 제안하기 위한 초안을 정리해 본다.

현 상태

* 개발 서버에서 모든 서비스의 배포와 테스트가 진행되고 있음
* 로컬 환경에서도 개발 서버의 DB를 보며 개발을 진행하고 있으며, 데모 시에 사용하는 DB 역시 개발 서버에서 수행됨
    * 개발 진행 중 테이블 구조를 바꾸는 경우도 발생하여 데모에 이슈를 야기하기도 함
* 따라서 개발서버는 새로운 기능 배포 및 테스트 용도
* QA 서버를 따로 배포하여, 운영 서버와 동일한 환경에서 데모 및 QA 수행이 필요해 보임

제안

* 운영 서버
* 개발 서버
    * 개발 수행 및 기능 테스트를 위한 서버
* QA 서버 (스테이징 서버)
    * 운영서버와 동일한 환경으로 세팅하여, 운영서버 배포 전 QA 용도로 사용
    *  QA 수행 및 데모 시의 문제를 확인함
        * DB 변동에 의한 데모 및 테스트 문제가 여러번 발생함
        * 로컬 환경에서도 개발 서버를 바라보기 때문에 더 문제가 발생
            * 따라서 DB, 서버, 클라이언트, Explorer(blockscout) 등을 배포해 테스트하는 서버 필요
728x90
반응형
728x90
반응형

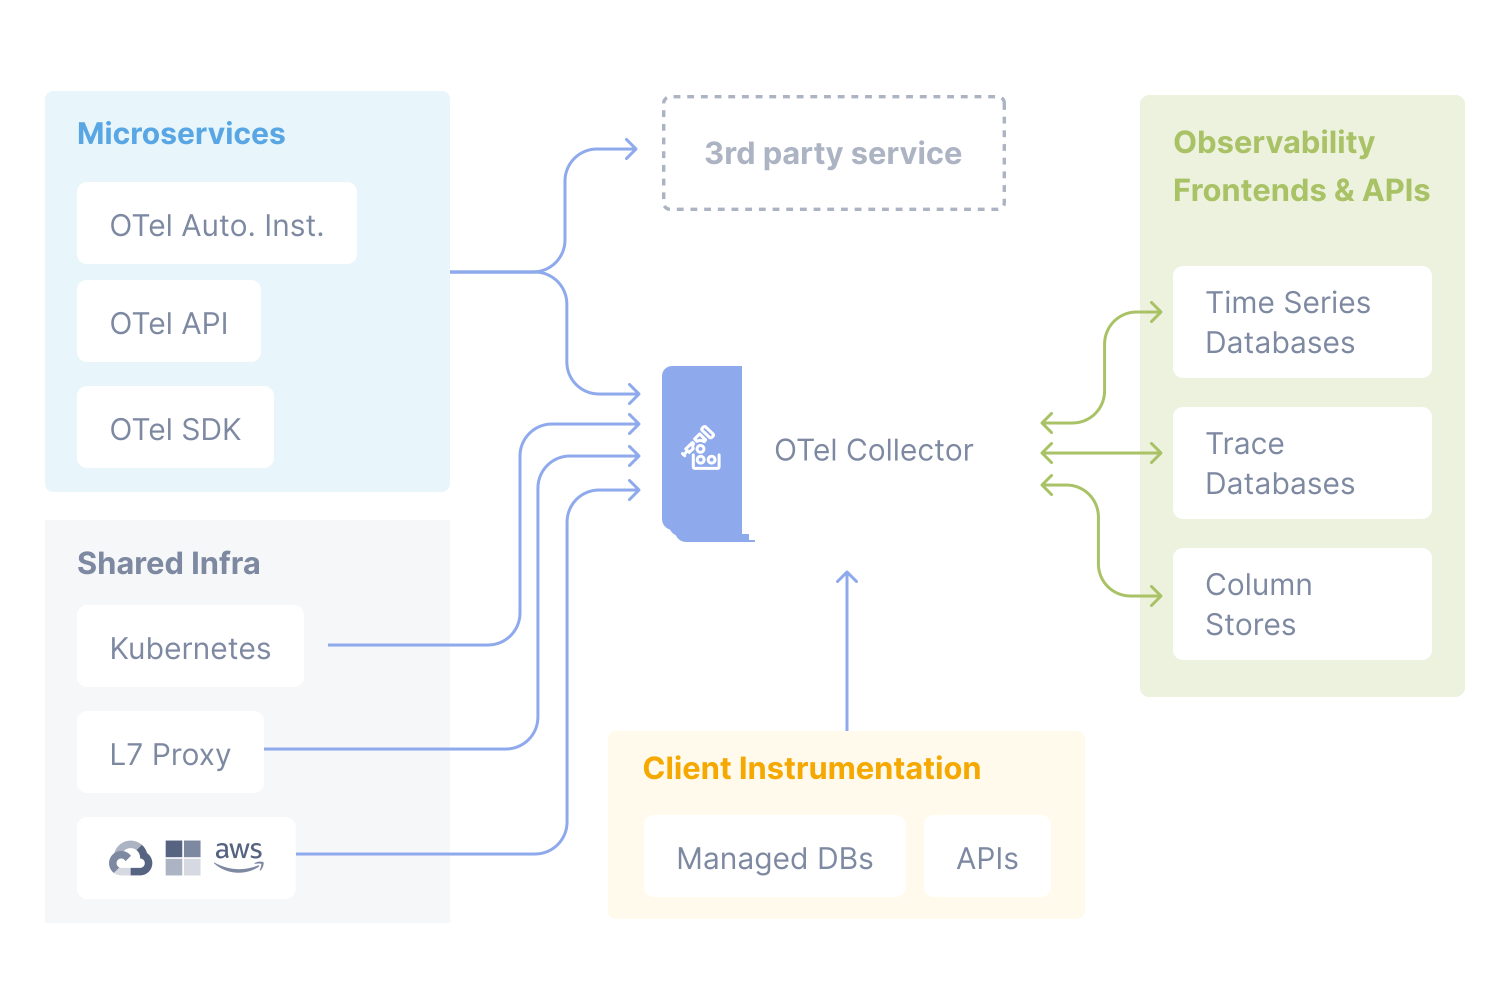
OpenTelemetry(OTel)

OpenTelemetry란?

  • Traces, Metrics, Logs 와 같은 데이터 instrumenting, generating, collecting, exporting 할 수 있는 Observability Framework.
  • 데이터를 수집, 변환 및 벡엔드 전송을 위한 표준화된 SDK / API / OTel Collector 제공을 목표로 함.
  • OTLP: OpenTelemetry Protocol
  • Prometheus, OTLP, Jaeger, Zipkin 등 매우 다양하고 많이 있음
    • Loki: Log 데이터의 Receiver
    • Prometheus: Metrics 에 대한 Receiver
    • Grafana Tempo: Trace에 대한 Receiver

필요한 이유

  • 표준화 된 데이터 수집 / 내보내기 / 관리가 가능해짐
    • 확장 및 이전이 용이해짐
  • 시스템 운영에 필요한 정보들을 직접 수집 및 모니터링이 가능함
  • 데이터 관리자 중앙집중화 되어 관리가 용이함
    • 특히 MSA 와 같은 분산 시스템에서 효과적임

용어 정리

  • Traces
    • 어플리케이션 / 클러스터 등에서 수행된 동작들 간의 지연(Latency)와 관계에 대한 데이터
  • Metrics
    • 시계열 데이터. 즉 시간의 순서에 따라 기록되는 숫자 및 통계적 데이터
    • 일정 시간마다 수집됨
    • 수치 값을 통해 이상 징후 감지 가능
  • Logs
    • 요청이 수행되는 동안 시스템의 임의의 시점에서 발생한 이벤트에 대한 데이터
    • 일반적으로 timestamp와 context payload를 포함함
    • json, binary 등의 형태로 기록됨
  • Observability
    • 아웃풋을 설명함으로써 시스템 내부 상태를 이해할 수 있게 하는 것을 의미
      • Traces, Metrics, Logs와 같은 telemetry data를 통해 시스템 내부 상태를 이해하게 됨을 의미
    • 즉, 코드는 반드시 traces, metrics, logs 와 같은 데이터를 산출해야 하고 observability 백엔드로 전송해야만 함

아키텍처

  • 개별 언어별 SDK
  • 데이터 수집
  • 변환 및 데이터 내보내기
  • 등

OpenTelemetry Collector

  • 원격 측정 데이터(Metrics / Traces / Logs) 수신 및 처리
  • 이후 OpenTelemetry 백엔드로 데이터 내보내기
  • 구성
    • Receivers
      • gRPC / HTTP 통해 데이터 수신
      • 하나 이상의 Receivers 구성 가능
    • Processors
      • 수신한 데이터를 OpenTelemetry 보내기 전 데이터 처리
    • Exporters
      • 데이터를 하나 이상의 OpenTelemetry 백엔드로 내보내기
      • 하나 이상의 Exporter 사용 가능

단점

  • 기능 및 옵션의 다양화로 인한 러닝 커브 존재
  • 직접 데이터 수집 및 관리하기 때문에 운영 및 관리에 대한 부담이 증가

OpenTelemetry Collector 데모

728x90
반응형

'데브옵스 devOps > Monitoring' 카테고리의 다른 글

[PROMETHEUS] 프로메테우스  (2) 2024.10.17

+ Recent posts